دو برآمدات منتخب کریں اور کالموں کی واضح میپنگ کے ساتھ اجزاء کے حوالوں کا موازنہ کریں۔
فی فائل 400,000 بائٹس · 100,000 UTF-16 اکائیاں · 500 ڈیٹا قطاریں
منتخب برآمدات کا موازنہ کریںتصاویر بڑھائیں، اشیا مٹائیں، SVG ٹریس کریں، PDF متن نکالیں، انگریزی دستاویز تلاش کریں، سب ٹائٹل بنائیں، PDF میں ترمیم کریں۔
مفت، کسی اکاؤنٹ کی ضرورت نہیں۔ آپ کی فائلیں آپ کے براؤزر میں پراسیس ہوتی ہیں۔ کچھ ٹولز پہلی بار استعمال پر انجن یا ماڈل ڈاؤن لوڈ کرتے ہیں۔
دو برآمدات منتخب کریں اور کالموں کی واضح میپنگ کے ساتھ اجزاء کے حوالوں کا موازنہ کریں۔
فی فائل 400,000 بائٹس · 100,000 UTF-16 اکائیاں · 500 ڈیٹا قطاریں
منتخب برآمدات کا موازنہ کریںنام والے خانوں اور سمت والے رابطوں سے بہاؤ یا ساخت کا خاکہ بنائیں۔
1–100 خانے استعمال کریں۔ زیادہ سے زیادہ 200 رابطے استعمال کریں۔
خاکہ بنائیںجامد GLB ماڈل کا حجم کم کریں۔ ڈاؤن لوڈ سے پہلے اصل اور نتیجے کا موازنہ کریں۔
ایک GLB · 25 MiB · صرف جامد ماڈل
ماڈل بہتر بنائیںReal-ESRGAN کے ذریعے براؤزر میں چھوٹی تصویر یا خاکہ بڑا کریں۔
PNG / JPG / WebP · ایک فائل · 10 MiB فی فائل · 1024 px فی طرف · 1,000,000 پکسل · 2× / 4× PNG نتیجہ. پہلی بار ماڈل ڈاؤن لوڈ، انجن الگ: 4.72 MiB.
عمل شروع کریںچھوٹی غیر ضروری چیز پر رنگ لگائیں تاکہ MI-GAN پس منظر کا اندازہ لگائے۔
PNG / JPG / WebP · ایک فائل · 10 MiB فی فائل · 2048 px فی طرف · 4,000,000 پکسل · PNG نتیجہ. پہلی بار ماڈل ڈاؤن لوڈ، انجن الگ: 26.78 MiB.
عمل شروع کریںVTracer سے راسٹر لوگو یا خاکہ حقیقی قابلِ تدوین SVG پاتھ میں بدلیں۔
PNG / JPG / WebP · ایک فائل · 10 MiB فی فائل · 1024 px فی طرف · 1,000,000 پکسل · SVG نتیجہ ≤ 5 MiB.
عمل شروع کریںتصاویر یا اسکین شدہ PDF صفحات سے مطبوعہ متن نکالیں، نتیجہ درست کریں اور TXT فائل ڈاؤن لوڈ کریں۔
زیادہ سے زیادہ 10 تصاویر (مجموعی طور پر 50 MiB) یا 20 صفحات کی ایک PDF؛ ہر فائل زیادہ سے زیادہ 20 MiB۔ جدولوں اور ہاتھ سے لکھے متن کو خود جانچیں؛ قابلِ تلاش PDF برآمد نہیں ہوتی۔
متن نکالیںمعاونت یافتہ PDF متن بدلیں، نوٹس شامل کریں، معاونت یافتہ فارم پُر کریں اور PDF کی نقل برآمد کریں۔
ایک PDF: زیادہ سے زیادہ 20 MiB اور 200 صفحات۔ اسکین شدہ متن براہِ راست قابلِ تدوین نہیں؛ متبادل متن کا فونٹ مختلف ہو سکتا ہے۔
PDF میں ترمیم کریںPDF Inspector فونٹ اور ترتیب دیکھ کر عنوان، جدول اور متن مقامی طور پر نکالتا ہے۔
PDF · ایک فائل · 20 MiB فی فائل · 1–100 PDF صفحات. متنی PDF؛ OCR نہیں۔
عمل شروع کریںMiniLM سے انگریزی دستاویز میں متعلقہ اقتباسات تلاش کریں، چاہے سوال کے الفاظ مختلف ہوں۔
PDF / TXT / MD · زیادہ سے زیادہ 10 فائلیں · 5 MiB فی فائل · کل 20 MiB · 1–100 PDF صفحات · 200 اقتباسات · 250,000 نکالے گئے حروف. پہلی بار ماڈل ڈاؤن لوڈ، انجن الگ: 22.59 MiB. انگریزی دستاویزات اور سوالات؛ جواب تیار نہیں ہوتا۔ TXT اور Markdown میں UTF-8 انکوڈنگ ضروری ہے۔ متن کو مقامی ماڈل کی حد کے مطابق اقتباسات میں تقسیم کیا جاتا ہے۔ تکنیکی اصطلاحات والا متن 200 اقتباسات کی حد تک جلد پہنچ سکتا ہے؛ ضرورت ہو تو فائلیں تقسیم کریں۔ مسترد سوال مختصر کر کے دوبارہ تلاش کریں؛ اشاریہ دوبارہ بنانے کی ضرورت نہیں۔
عمل شروع کریںانگریزی آواز کی مقامی طور پر شناخت کریں، متن اور اوقات جانچیں، پھر SRT یا VTT سب ٹائٹلز برآمد کریں۔
فی الحال شناخت صرف انگریزی کے لیے ہے۔ اوقات تخمینی ہیں۔ آڈیو یا ویڈیو زیادہ سے زیادہ 100 MiB اور 10 منٹ۔
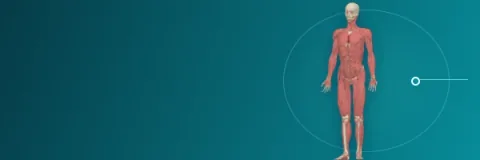
سب ٹائٹلز بنائیںحقیقی 3D جسمانی ماڈل گھمائیں، ساخت تلاش کریں اور جسم کے نظام الگ دکھائیں یا جدا کریں۔
WebGL 2 اور ماڈل ڈاؤن لوڈ درکار ہیں۔ یہ سادہ بنایا گیا تعلیمی ماڈل ہے، طبی فیصلوں کے لیے نہیں۔
ماڈل دیکھیںمتن والے PDF کے جدول CSV یا JSON میں نکالیں۔ ڈاؤن لوڈ سے پہلے ہر خانے کا اصل صفحے سے موازنہ کریں۔
ایک PDF · 20 MiB · زیادہ سے زیادہ 20 صفحات
PDF منتخب کریںمختصر MP4 کا منظر انگریزی میں بیان کریں، منتخب فریموں کی درجہ بندی دیکھیں، اصل جانچیں اور مختصر JSON رپورٹ ڈاؤن لوڈ کریں۔
ایک MP4؛ 50,000,000 بائٹس؛ پڑھی گئی مدت زیادہ سے زیادہ 120 سیکنڈ، اور منتخب وقفے کی 20 نمونوں کی حد بھی لاگو ہے۔ · WebGPU
لمحات تلاش کریںتصاویر اور اسکین شدہ صفحات کے لیے متن نکالنے والا ٹول استعمال کریں؛ PDF میں معاونت یافتہ متن بدلنے کے لیے PDF ایڈیٹر استعمال کریں۔ سب ٹائٹل اسٹوڈیو میں انگریزی ریکارڈنگ یا موجودہ سب ٹائٹل فائل سے آغاز کریں۔ بڑی فائل کھولنے سے پہلے حدود پڑھیں اور برآمد شدہ نتیجہ جانچیں۔