高度なツール
画像拡大、物体消去、SVG トレース、PDF 抽出、英語文書検索、字幕作成、PDF 編集。
無料で、登録は不要です。ファイルはブラウザー内で処理されます。一部のツールは初回使用時にエンジンやモデルをダウンロードします。
Real-ESRGAN を使い、ブラウザ内で小さな写真やイラストを拡大します。
PNG / JPG / WebP · 1 ファイル · 10 MiB 各ファイル · 1024 px 各辺 · 1,000,000 画素 · 2× / 4× PNG 出力. 初回モデルのダウンロード(エンジンは別途): 4.72 MiB.
処理する
小さな不要物を塗り、MI-GAN で背景を推測します。
PNG / JPG / WebP · 1 ファイル · 10 MiB 各ファイル · 2048 px 各辺 · 4,000,000 画素 · PNG 出力. 初回モデルのダウンロード(エンジンは別途): 26.78 MiB.
処理する
VTracer でラスターのロゴや絵を編集可能な SVG パスに変換します。
PNG / JPG / WebP · 1 ファイル · 10 MiB 各ファイル · 1024 px 各辺 · 1,000,000 画素 · SVG 出力 ≤ 5 MiB.
処理する
画像やスキャンした PDF ページから印刷文字を抽出し、修正して TXT ファイルをダウンロードできます。
画像は最大 10 枚(合計 50 MiB)、または最大 20 ページの PDF 1 件。1 ファイル最大 20 MiB。表や手書き文字は手動確認が必要で、検索可能な PDF は出力しません。
文字を抽出
対応する PDF の文字を置換し、注釈を追加し、対応するフォームに入力して PDF のコピーを書き出します。
PDF 1 件、最大 20 MiB、200 ページ。スキャンした文字は直接編集できず、置換後のフォントが変わる場合があります。
PDF を編集
PDF Inspector がフォントとレイアウトを分析し、見出し、表、本文をローカルで抽出します。
PDF · 1 ファイル · 20 MiB 各ファイル · 1–100 PDF ページ. 文字 PDF 対応。OCR はありません。
処理する
MiniLM で英語の文書から関連する抜粋を探します。
PDF / TXT / MD · 最大 10 ファイル · 5 MiB 各ファイル · 合計 20 MiB · 1–100 PDF ページ · 200 抜粋 · 250,000 抽出文字. 初回モデルのダウンロード(エンジンは別途): 22.59 MiB. 英語の文書と英語の質問に対応。回答は生成しません。 TXT と Markdown は UTF-8 が必要です。 本文はローカルモデルで処理できる長さの抜粋に分割されます。専門用語が多いと 200 件の上限に早く達する場合があるため、その場合はファイルを分けてください。質問が長すぎて拒否された場合は短くして再試行できます。索引の作り直しは不要です。
処理する
英語の音声をローカルで認識し、文字とタイミングを確認して SRT または VTT 字幕を書き出します。
音声認識は現在、英語のみ対応しています。タイミングは推定値です。音声・動画は最大 100 MiB、10 分です。
字幕を作成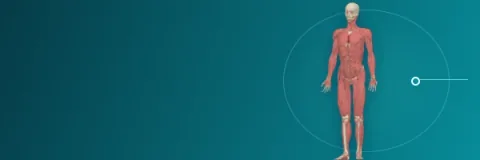
実際の 3D 人体モデルを回転し、構造を検索して、身体の系統を単独表示または分離します。
WebGL 2 とモデルのダウンロードが必要です。学習用に簡略化した形状で、医療判断には使用できません。
モデルを探索
短い MP4 の場面を説明し、サンプル画像を類似度順に並べ、元動画を確認してコンパクトな JSON レポートを保存できます。
MP4 1本、50,000,000バイト以下。解析した長さは120秒以下で、選んだ間隔のサンプル20回制限も満たす必要があります。 · WebGPU
場面を検索どのツールを選べばよいですか?
画像やスキャンしたページには文字抽出を、PDF 内の対応する文字の変更には PDF エディターを使ってください。字幕スタジオは英語の録音や既存の字幕ファイルから始められます。大きなファイルを開く前に制限を確認し、書き出した結果も確認してください。